Newsletter · 25. Oktober 2026
Weekly Digest 43
Google und Amazon greifen Nvidias Software-Burggraben an. Außerdem: Nvidias modulares Rechenzentrumskonzept, Kimi K3.1 Pro und wie Zollrisiken und Vorgaben für den chinesischen Schrotthandel den Kupfermarkt verzerren.
Themen, die wir verfolgen
Google und Amazon greifen Nvidias Software-Burggraben an
Quellen: AWS · Google Cloud · SemiAnalysis / InferenceX
Nvidias dominante Marktposition stützt sich seit Jahren auch auf sein CUDA-Ökosystem, das häufig als „CUDA-Burggraben“ bezeichnet wird. Wir glauben allerdings, dass dieser Burggraben nach und nach schwächer geworden ist. Nvidia weiß das und hat Milliarden Dollar in den Aufbau einer Lieferkette investiert, die wir inzwischen als den Burggraben des Unternehmens betrachten. Auch auf der Softwareseite hat sich Nvidia an die veränderten Bedingungen angepasst, seine Python-Tools ausgebaut und die Integration mit Frameworks wie PyTorch weiter verbessert. CUDA war ursprünglich auf C/C++ ausgerichtet, Entwickler können es aber schon seit Jahren über Python nutzen. Mit optimierten Kernels und Kommunikations-Tools hat Nvidia es kontinuierlich einfacher gemacht, eine breite Palette an Modellen effizient auf der eigenen Hardware auszuführen.
Diese Woche haben Google und Amazon neue Softwarepakete vorgestellt, mit denen Entwickler ihre bestehenden PyTorch-Modelle leichter auf den eigens entwickelten KI-Chips der beiden Unternehmen ausführen können. Amazons neues TorchNeuron-Paket ist jetzt als öffentliche Beta verfügbar und bietet native PyTorch-Unterstützung für die Trainium2- und Trainium3-Chips. Gleichzeitig hat Google die Veröffentlichung von TorchTPU als Open Source sowie neue Integrationen mit verbreiteten Inferenzbibliotheken wie SGLang angekündigt.
TPU und Nvidia: Kosten bei einem agentischen Workload
Qwen3.5-397B-A17B · AgentX · Vergleich vom 19. Oktober 2026 · Höher ist besser
TPU v7 liegt bei 150–400 Tok./s je Nutzer vor GB300 FP8; GB300 FP4 liegt an diesen Punkten vor beiden. Mio. Gesamt-Tokens / 1 $ TCO. TPU v7 · FP8: 100: 119.0, 150: 110.9, 200: 102.4, 300: 75.2, 400: 60.1; GB300 · FP8: 100: 121.2, 150: 88.6, 200: 55.5, 300: 37.2, 400: 26.8; GB300 · FP4: 150: 217.2, 200: 188.1, 300: 137.0, 400: 84.3. Interpolierte Schätzwerte; TPU-Vorschau. Gesamt-Tokens inkl. gecachter Eingaben. Modellierte TCO externer Käufer, keine API-Preise. Wartezeit bis zum ersten Token nicht abgeglichen; Antwortqualität nicht bewertet. Systeme unterscheiden sich. Kein FP4-Wert bei 100 Tok./s.
P90-Ausgabetempo (Ausgabe-Tokens/s je Nutzer)
Interpolierte Schätzwerte; TPU-Vorschau. Gesamt-Tokens inkl. gecachter Eingaben. Modellierte TCO externer Käufer, keine API-Preise. Wartezeit bis zum ersten Token nicht abgeglichen; Antwortqualität nicht bewertet. Systeme unterscheiden sich. Kein FP4-Wert bei 100 Tok./s.
Quelle: SemiAnalysis / InferenceX · 2026-10-19
Mit der neuen Software können Entwickler größere Teile ihres bestehenden Modellcodes übernehmen und ihre gewohnten Debugger und Trainingsabläufe weiterverwenden. Die Chips unterstützten PyTorch bereits zuvor. Die bisherigen Integrationen erforderten jedoch häufig Anpassungen an der Implementierung oder an den Arbeitsabläufen. Laut Hugging Face unterstützt TorchNeuron nun 89 der 100 meistgenutzten Modellarchitekturen zur Textgenerierung von Haus aus, gegenüber 46 mit Optimum Neuron v0.4.5. Google hat außerdem bekannt gegeben, dass sein neues PyTorch-basiertes SGLang-Backend bei Meta bereits im Produktivbetrieb läuft.
Bislang hatten Google und Amazon wohl weniger Anreize, diese Software-Stacks einem breiteren Entwicklerkreis zugänglich zu machen. Google nutzt TPUs intern, ebenso wie große KI-Labs wie Anthropic, die über das technische Know-how und die Ressourcen verfügen, in eigene Software zu investieren. Da beide Unternehmen eine breitere Nutzung ihrer Chips anstreben, wird das Software-Ökosystem wichtiger und stützt ihre Investitionen in eigene Chipentwicklungen. Nvidia beschäftigt zahlreiche Softwareentwickler, die optimierte Bibliotheken, Kernels und Kommunikations-Tools entwickeln und pflegen, damit Kunden ihre Modelle effizient auf der Hardware des Unternehmens ausführen können.
Nvidia stellt ein modulares Rechenzentrumskonzept vor
Quelle: Nvidia · Pressemitteilung · Bild
Diese Woche hat Nvidia auf der GTC in Berlin den DSX POD vorgestellt: ein Referenzdesign für ein modulares KI-Rechenzentrum auf Basis der Vera-Rubin-Plattform. Partner wie Dell, Schneider Electric, HPE und Vertiv sollen Systeme liefern, die vor dem Versand in Containern vormontiert und getestet werden. Die Verfügbarkeit ist für Anfang 2027 geplant.
Jensen spricht schon lange von der KI-Fabrik. Nun scheint er auch den Bauplan dafür vorgelegt zu haben. Die Idee ist, Rechenhardware, Netzwerktechnik, Verkabelung sowie die Stromversorgung und Kühlung auf Rack-Ebene in einem werkseitig vorgefertigten System zu standardisieren. Laut Nvidia könnte sich dadurch die Zeit für die Installation an einem vorbereiteten Standort von sechs Monaten auf nur zwei Wochen verkürzen. Solange die Nachfrage nach Tokens das Angebot übersteigt, können Rechenzentren praktisch Gelddruckmaschinen sein. Entsprechend groß ist der finanzielle Anreiz, sie mehrere Monate früher in Betrieb zu nehmen. Ein modularer Aufbau würde außerdem spätere Erweiterungen erleichtern und könnte den Bedarf an den ohnehin knappen Fachkräften auf der Baustelle senken.
Für Nvidia ist das ein weiterer Weg, seine zentrale Stellung im Ökosystem abzusichern. Das Unternehmen hat in fast alle Bereiche der Lieferkette für Rechenzentren investiert. Dadurch spielt es auf nahezu jeder Ebene eine zentrale Rolle, wenn es darum geht, Lieferkontingente und bevorzugten Zugang zu sichern. Über sein Partnernetzwerk kann Nvidia Projektentwicklern den Zugang zu Kühl-, Netzwerk- und Stromversorgungstechnik erleichtern. All diese Komponenten sind knapp und haben lange Lieferzeiten.
Kimi veröffentlicht K3.1 Pro
Quellen: Moonshot · Artificial Analysis
Jie Tang von Z.ai hatte dieses Jahr auf Twitter angedeutet, dass wir noch vor Jahresende ein Modell auf Fable-Niveau bekommen würden. Zwei Monate vor Jahresende haben wir mit Kimi K3.1 Pro nun einen starken Kandidaten: ein Modell mit 2,8 Billionen Parametern, das im Artificial Analysis Intelligence Index vor Claude Fable 5.1 und GPT-6 Astra liegt. Moonshot plant, die Modellgewichte bis zum 4. November zu veröffentlichen. Technische Details gibt es nur wenige, was bei einem Versionsupdate dieser Art üblich ist. Die weiteren Fortschritte führt das Unternehmen in seinem Blogbeitrag vor allem auf deutlich mehr Post-Training mit Reinforcement Learning zurück.
Artificial Analysis Intelligence Index
 Claude Opus 5.5max · mit FallbackClaude Sonnet 5.5max · mit Fallback
 Muse Wonder Fullmax
 Kimi K3.1 Proneues ModellClaude Fable 5.1max · mit Fallback
 GPT-6 Astramax
 Gemini 4 ArgonhighGPT-6.1 SolmaxMuse WondermaxKimi K3max · Vorgänger
Die Veröffentlichung umfasst auch eine Highspeed-Version, die laut Moonshot Tokens zwei- bis dreimal so schnell ausgibt. Wir glauben, dass die Labs neben Effizienz und Leistungsfähigkeit künftig verstärkt auch die Geschwindigkeit ihrer Modelle verbessern werden. Moonshot bietet außerdem Kimi Hosted Agents an, eine gehostete Umgebung für Agenten, die über längere Zeit im Hintergrund arbeiten können. Der Zusatz „Pro“ könnte auf eine künftige günstigere und kleinere „Flash“-Version hindeuten, die für viele Nutzer wirtschaftlich attraktiver sein könnte. Flash-Varianten belegen derzeit vier der ersten fünf Plätze in der wöchentlichen OpenRouter-Rangliste nach Tokenvolumen.
Moonshot gibt an, aus Sicherheitsgründen Inhalte zur Cybersicherheit aus den Datensätzen für das Mid-Training und das Reinforcement Learning entfernt zu haben. Dennoch schnitt das Modell bei Cyber-Benchmarks sehr gut ab und führt im Cyber Index von Artificial Analysis die öffentlich zugänglichen Modelle an. Viele der veröffentlichten Coding-Benchmarks wurden mit Claude Code als Agentenumgebung durchgeführt. Die Ergebnisse hängen damit sowohl vom Modell als auch von seiner Umgebung ab. Wie gut sich diese Werte auf eine andere Konfiguration übertragen lassen, bleibt unklar. Auch bei Kimi K3 haben wir bei einzelnen Benchmarks Unterschiede zwischen Inferenzanbietern gesehen. Die Hosting-Konfiguration ist deshalb ein weiterer Faktor bei der Bewertung solcher Ergebnisse.
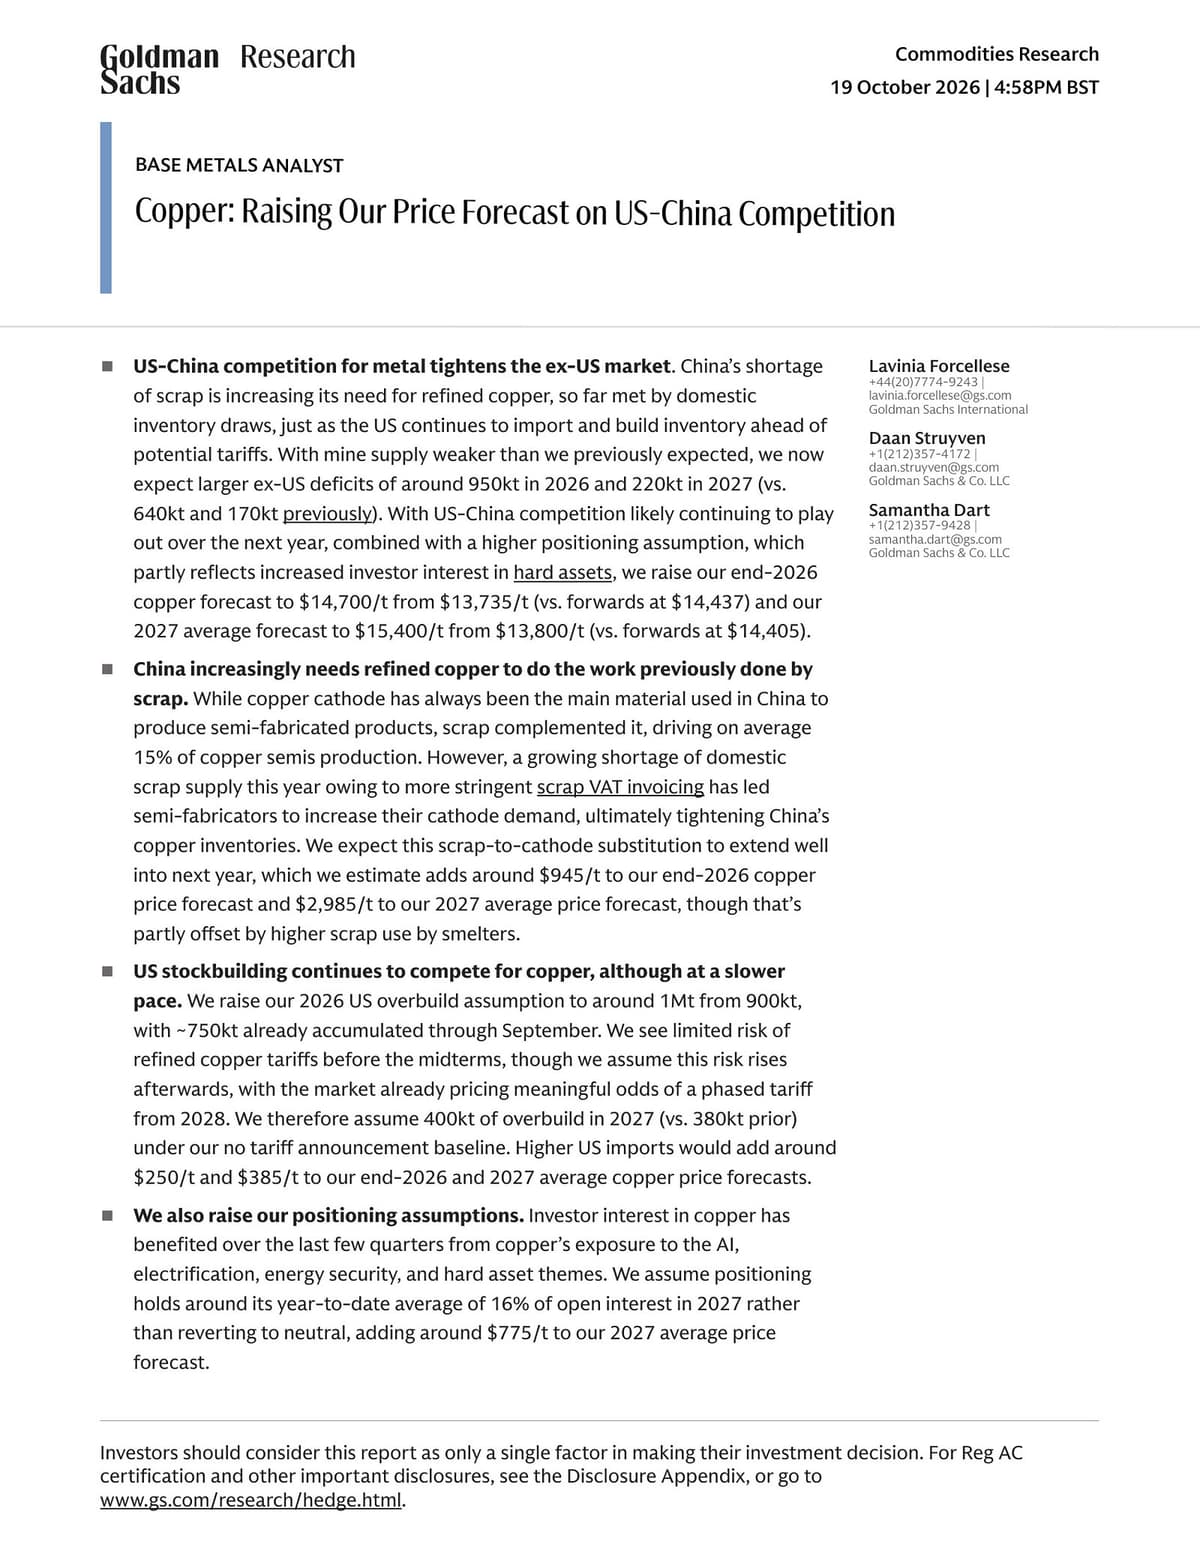
Goldman Sachs hebt seine Kupferpreisprognosen an
Quellen: Goldman Sachs Research — erste Seite · Kupferpreise: Westmetall · Cochilco
Goldman Sachs hat kürzlich sein Kupferpreisziel für das Jahresende auf 14.700 Dollar je Tonne angehoben und seine Prognose für den Durchschnittspreis 2027 auf 15.400 Dollar erhöht. Die Investmentbank rechnet nun mit einer angespannteren Versorgungslage außerhalb der USA. Das führt Goldman teilweise auf zwei politische Faktoren zurück: mögliche US-Einfuhrzölle und strengere Vorgaben für den Handel mit Kupferschrott in China. Die Aussicht auf Zölle veranlasst Kupferhändler dazu, Lieferungen in die USA vorzuziehen.
Kupferpreis seit Jahresbeginn
LME-Kassapreis für Kupfer · 2. Januar–23. Oktober 2026
206 tägliche LME-Kassapreise für Kupfer vom 2. Januar bis 23. Oktober 2026, in USD je Tonne. Die erste Notierung beträgt 12.571 und die letzte 14.415.
Tägliche LME-Kassapreise für Kupfer laut Westmetall; nur Handelstage. Fünf Stichtage mit den Original-Tagesberichten von Cochilco abgeglichen. Preise in USD je Tonne.
Quelle: Westmetall, Cochilco · 2026-10-23
Zum 22. Oktober lagerten in den Comex-Lagerhäusern rund 724.000 Tonnen Kupfer. Dadurch steht Käufern in anderen Märkten weniger Metall zur Verfügung. Ob Zölle auf raffiniertes Kupfer tatsächlich eingeführt werden, ist noch offen. Schon die Aussicht darauf rechtfertigt für Händler jedoch die Lagerhaltung in den USA. Der US-Markt kann also relativ gut versorgt sein, während es in Europa und China zunehmend eng wird. Laut Reuters hat Codelco europäischen Kunden für Lieferungen im kommenden Jahr Rekordaufschläge von 350 Dollar je Tonne auf den LME-Preis angeboten.
Gleichzeitig erschweren strengere steuerliche Vorgaben und Dokumentationsprüfungen in China den Herstellern die Beschaffung von Kupferschrott mit den erforderlichen Nachweisen. Einige Käufer weichen deshalb auf raffiniertes Kupfer aus. Muss etwa ein Kabelhersteller Kupferschrott durch raffiniertes Kupfer ersetzen, steigt seine Nachfrage nach raffiniertem Metall, auch wenn er dieselbe Kabelmenge produziert und insgesamt nicht mehr Kupfer verbraucht. Ausfälle in den Kupferminen verschärfen diese Marktungleichgewichte zusätzlich. Dennoch erwartet die Internationale Kupferstudiengruppe (ICSG) für das Gesamtjahr weiterhin einen kleinen Überschuss auf dem globalen Markt für raffiniertes Kupfer. Entscheidend für den Kupferpreis ist zunehmend, wo das Metall lagert und in welcher Form es Herstellern zur Verfügung steht. Eine Entscheidung über die US-Zölle oder eine bessere Verfügbarkeit von Kupferschrott in China könnte daher für etwas Entspannung sorgen, ohne dass die Minen dafür deutlich mehr Kupfer fördern müssten.
Auf X gesehen
Weitere interessante Artikel
- New York Times: Nicht nur Frankreich: Europas politische Mitte bröckelt
- Faint Signals: Welche Branche erobern die Quants als Nächstes?
- Vik’s Newsletter: Die vier apokalyptischen Reiter des KI-Infrastrukturausbaus
- Foreign Affairs: KI ist eine Entscheidung
- EZB: Die Widerstandsfähigkeit der Wirtschaft im Euroraum – einen Schock bewältigen, sich auf den nächsten vorbereiten